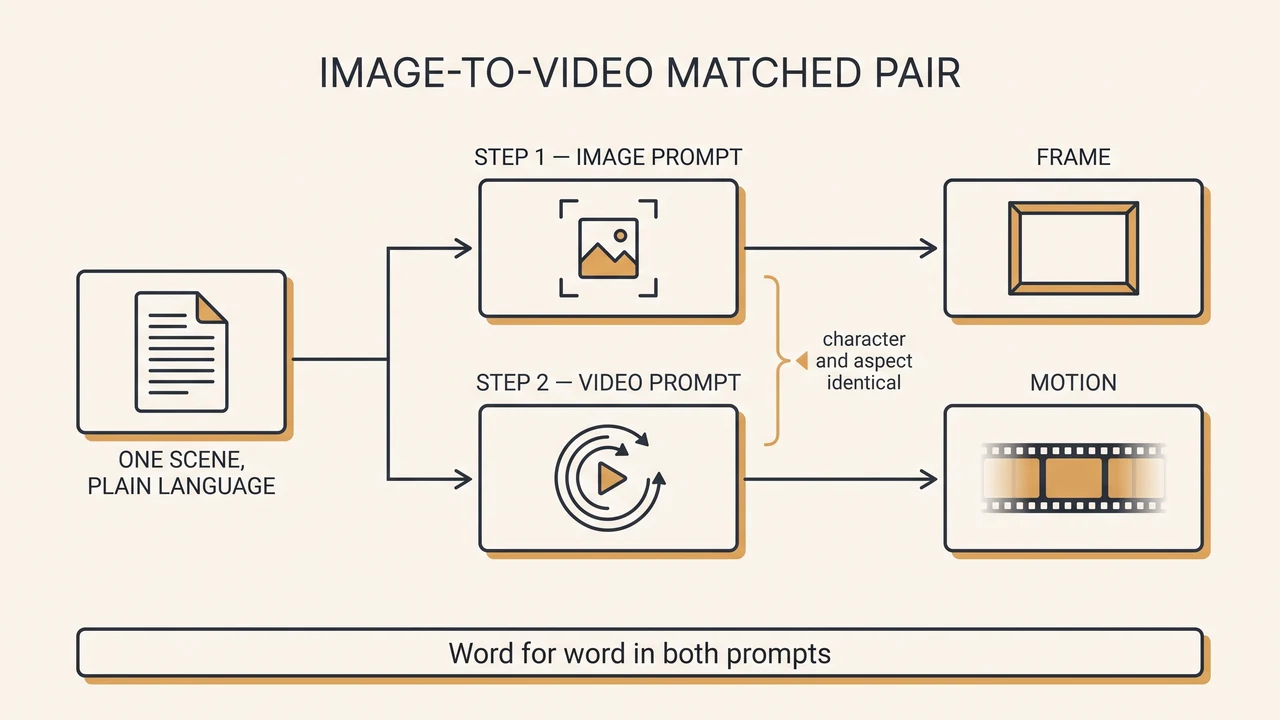
一个场景,两条配对提示词:图像提示词生成画面,视频提示词让它动起来——角色描述与画幅比在两者中必须逐字一致。
Dreamer 流程的核心功能:从一个纯文本场景一步生成匹配的图像和视频提示对。第一步生成图像,第二步对其进行动画处理——角色描述和宽高比在两个提示中完全相同,以便模型能够一致地延续同一角色和相同的画面构图。图像提示和视频提示之间的差异会产生漂移:角色在静态图像和第一帧之间外观或姿势发生变化。在对话场景中,不会使用文本到视频的唇形同步,而是将唇形同步应用于保持的静态图像,因为初始图像已经确定了面部表情,模型只需合成嘴部运动。除了角色和宽高比,还值得在两个提示之间匹配光照和色彩氛围以及相机视角,否则视频模型会尝试在第一帧中后期纠正静态图像,这会导致从图像到运动的过渡出现可见的跳跃。因此,匹配对被视为一个整体进行版本控制:如果图像提示中的某个细节发生变化,视频提示中的相应更正也会随之进行,否则在重复迭代时,两个提示部分会逐渐偏离。
继续浏览词典
相关术语
检验你的知识
测验
1. Zu welchem Department gehört „Image-to-Video Matched Pair"?